
 Алгебра
 Английский
 Биология
 География
 Геометрия
 История
 Русский
 Обществознание
 Физика
 Химия
 Информатика
 Литература
 Математика
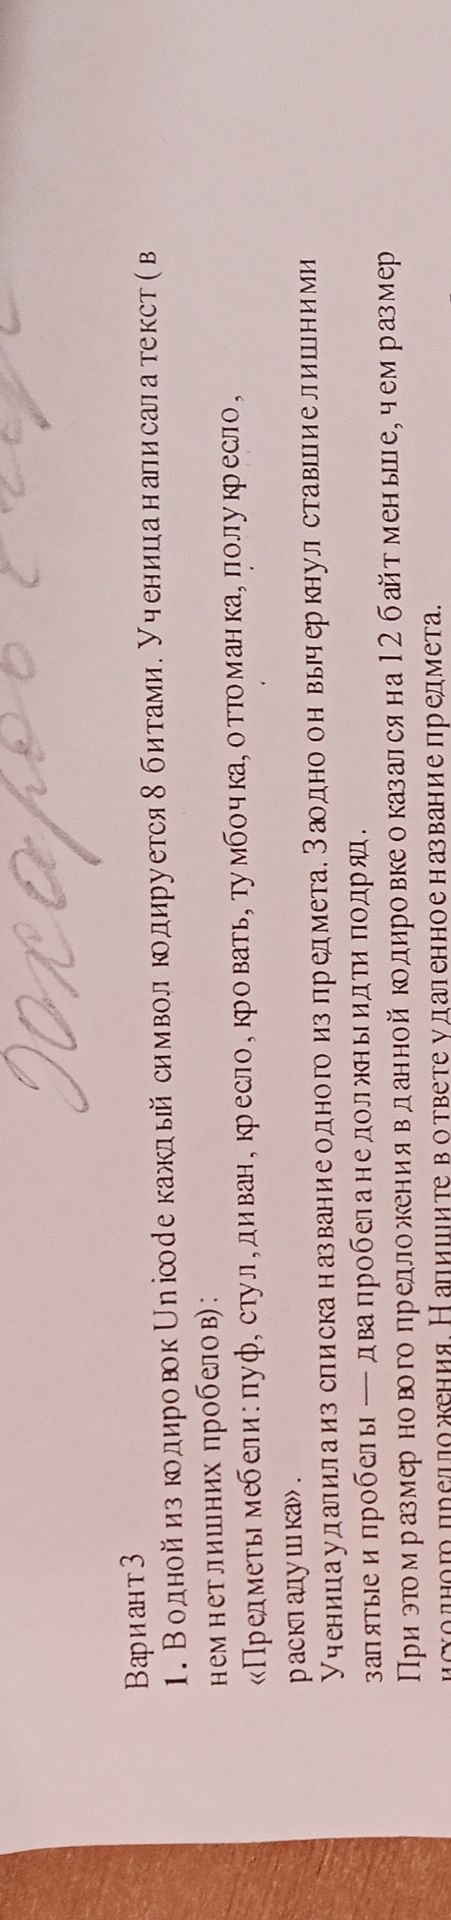
Ответ:
Решение:
1. Определим, сколько байт занимает исходный текст.
В тексте 10 слов, 2 знака препинания (двоеточие и точка), 10 запятых и 9 пробелов между словами.
Всего символов: 10 слов (считаем по 5 букв в среднем) + 2 знака + 10 запятых + 9 пробелов = 50 + 2 + 10 + 9 = 71 символ.
Каждый символ в Unicode кодируется 8 битами (1 байт). Таким образом, исходный текст занимает 71 байт.
2. Определим, сколько байт занимает новый текст.
Новый текст занимает на 12 байт меньше, то есть 71 - 12 = 59 байт.
3. Найдем, сколько символов было удалено.
Разница в размере (12 байт) соответствует количеству удаленных символов, так как каждый символ кодируется 1 байтом. Значит, было удалено 12 символов.
4. Определим, что было удалено.
Удалено было одно слово (название предмета) и два лишних пробела, которые остались после удаления слова. Получается, что название удаленного предмета состояло из 12 - 2 = 10 символов.
5. Найдем удаленное слово в списке.
Ищем слово из 10 букв в списке:
- пуф (3)
- стул (4)
- диван (5)
- кресло (6)
- кровать (7)
- тумбочка (8)
- оттоманка (9)
- полукресло (10)
- раскладушка (10)
Слова «полукресло» и «раскладушка» имеют по 10 букв. Однако, по условию, удаленное слово было одним из предмета мебели. «Раскладушка» — это тип дивана. «Полукресло» — это отдельный вид мебели.
Проверим, если удалить «полукресло» (10 букв), то останется 71 - 10 = 61 байт. Затем убираем 2 лишних пробела: 61 - 2 = 59 байт. Это соответствует условию.
Если удалить «раскладушка» (10 букв), то останется 61 байт. Убираем 2 лишних пробела: 59 байт. Это также соответствует условию.
Однако, «раскладушка» — это разновидность дивана, а не отдельный предмет мебели в данном списке. Вероятнее всего, удалили «полукресло».
Ответ: полукресло
