
 Алгебра
 Английский
 Биология
 География
 Геометрия
 История
 Русский
 Обществознание
 Физика
 Химия
 Информатика
 Литература
 Математика
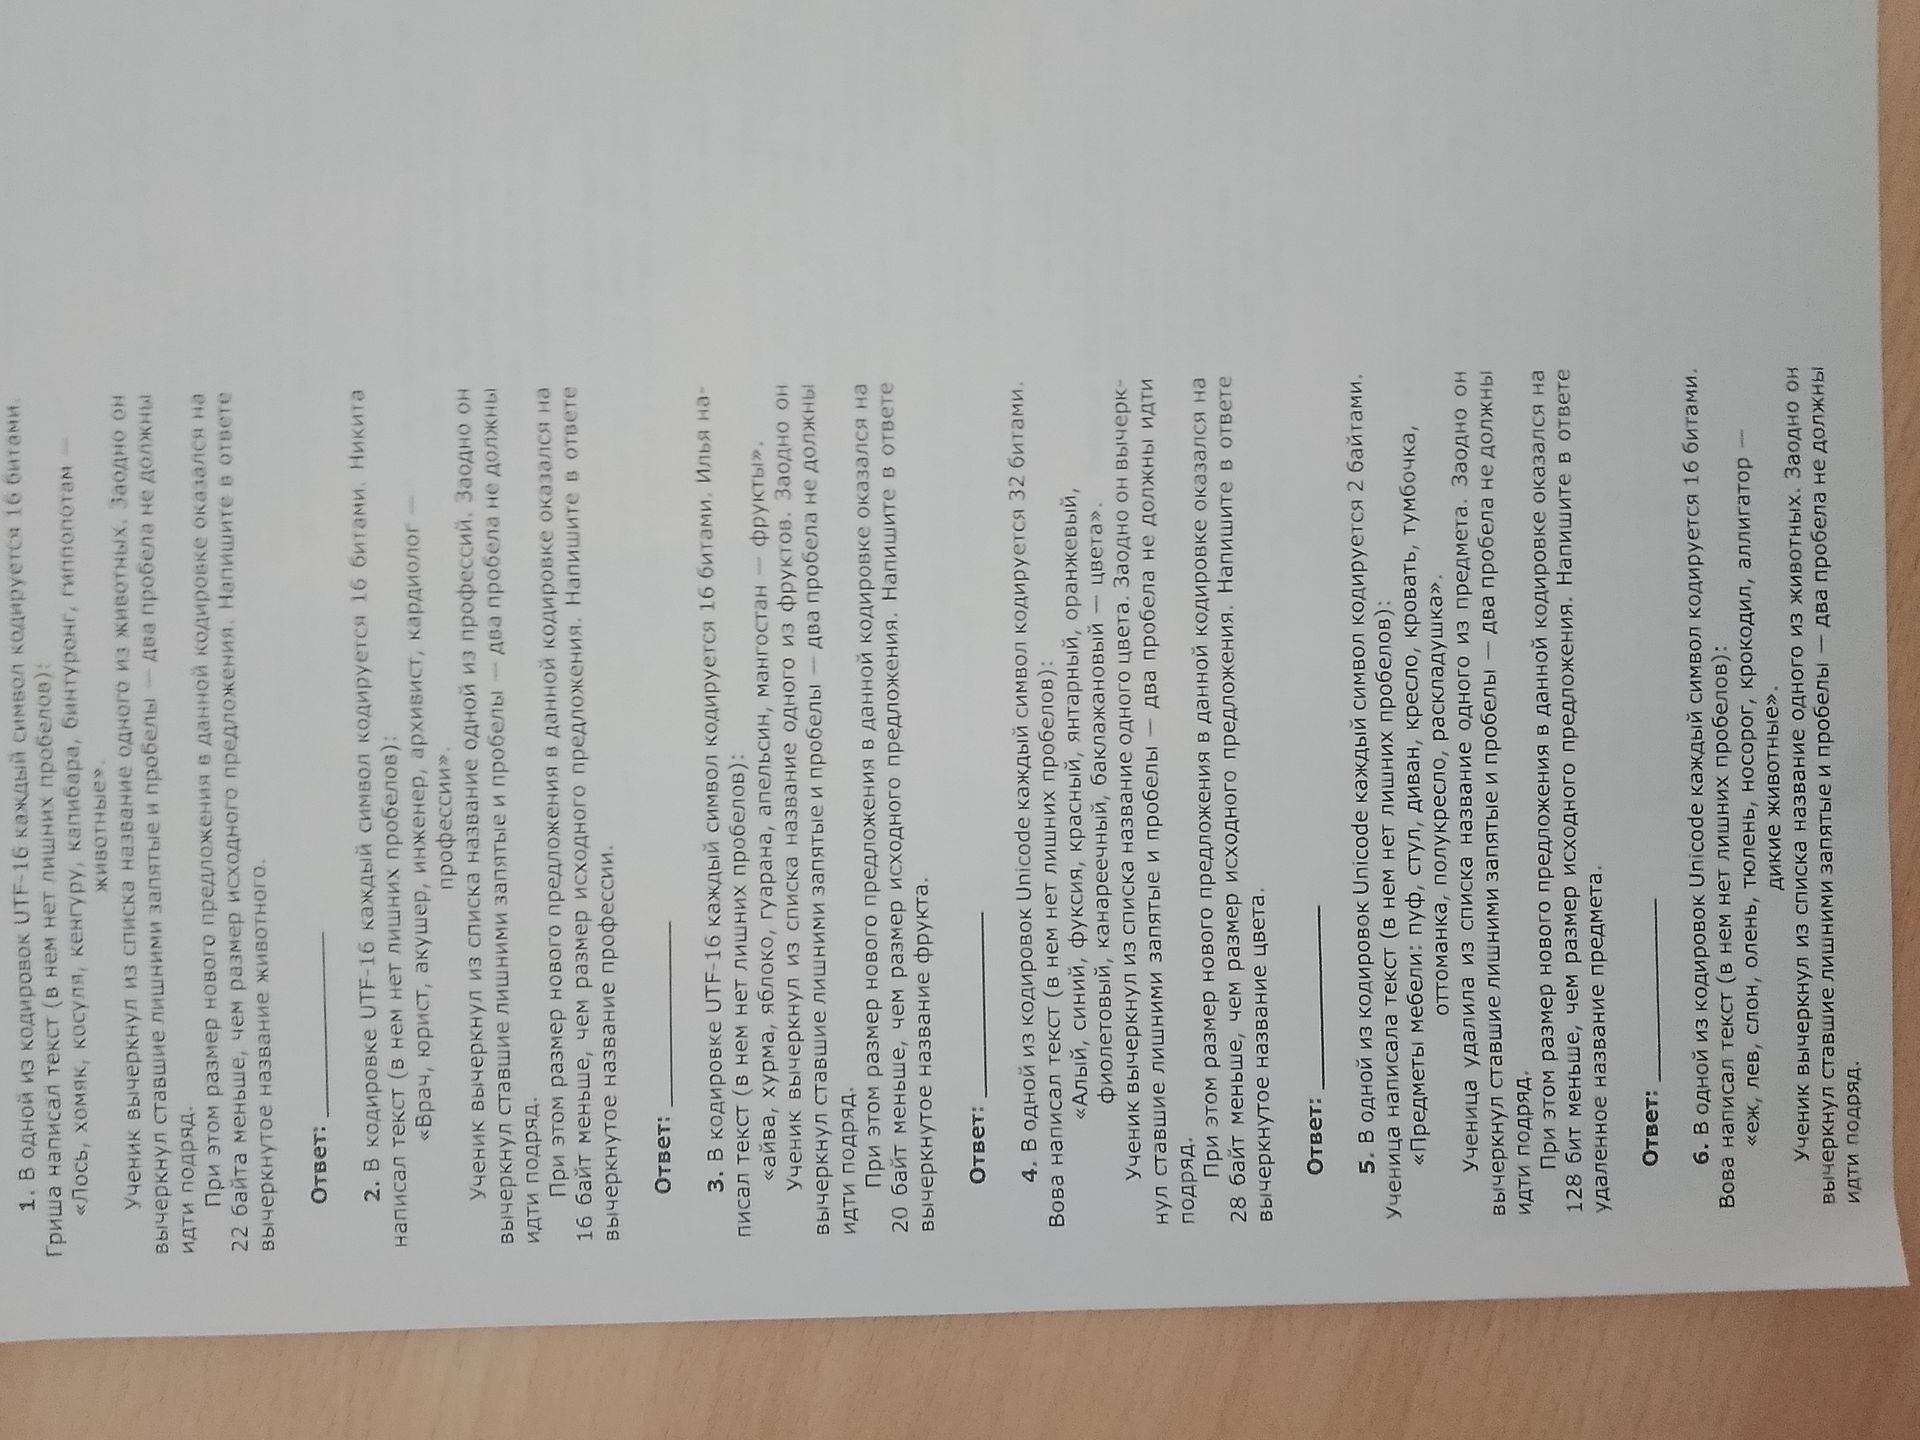
Ответ:
Задание 2. Кодировка UTF-16 и профессии
Логика решения:
- UTF-16 использует 16 бит (2 байта) на символ.
- Удаление одной профессии и лишних знаков препинания (запятых и пробелов) привело к уменьшению размера на 16 байт.
- Удаление 2 запятых и 2 пробелов занимает 4 байта.
- Размер названия профессии составил 16 байт - 4 байта = 12 байт.
- Так как один символ в UTF-16 занимает 2 байта, то название профессии состоит из 12 байт / 2 байта/символ = 6 символов.
- Из списка «Врач, юрист, акушер, инженер, архивист, кардиолог» только «юрист» и «врач» состоят из 5 букв. «Акушер» и «инженер» состоят из 6 букв.
- Проверим: «инженер» (7 букв, 14 байт) или «архивист» (9 букв, 18 байт).
- «Акушер» (6 букв, 12 байт).
- «Кардиолог» (9 букв, 18 байт).
- «Юрист» (5 букв, 10 байт).
- «Врач» (4 буквы, 8 байт).
- Исходя из условия, название профессии состоит из 6 символов.
- Из списка профессий «инженер» и «акушер» имеют 7 букв.
- Ошибка в расчете: 16 байт - 4 байта (2 запятые + 2 пробела) = 12 байт. 12 байт / 2 байта/символ = 6 символов.
- Снова смотрим список: «Врач» (4), «юрист» (5), «акушер» (6), «инженер» (7), «архивист» (9), «кардиолог» (9).
- Проверим снова: «архивист» - 9 букв, 18 байт. «кардиолог» - 9 букв, 18 байт. «инженер» - 7 букв, 14 байт. «акушер» - 6 букв, 12 байт.
- Исходя из условия (16 байт), подходящей является «акушер».
Ответ: акушер
