
 Алгебра
 Английский
 Биология
 География
 Геометрия
 История
 Русский
 Обществознание
 Физика
 Химия
 Информатика
 Литература
 Математика
Ответ:
Разбираемся с шифром
Привет! Давай вместе разберёмся, как работает этот шифр и как его взломать.
Как работает шифр:
- Каждая буква русского алфавита имеет свой номер. В задании сказано, что А — это 0, Б — это 1, и так далее до Я, которая имеет номер 31. Всего в таком алфавите 32 буквы.
- Когда текст шифруется, к номеру каждой буквы добавляется её порядковый номер в исходном тексте.
- Например, первая буква 'А' (номер 0) получит +0, вторая 'Б' (номер 1) получит +1, третья 'В' (номер 2) получит +2 и так далее.
Как расшифровать:
Чтобы расшифровать текст, нужно сделать обратную операцию: вычесть из номера зашифрованной буквы её порядковый номер в тексте.
Вносим изменения в код:
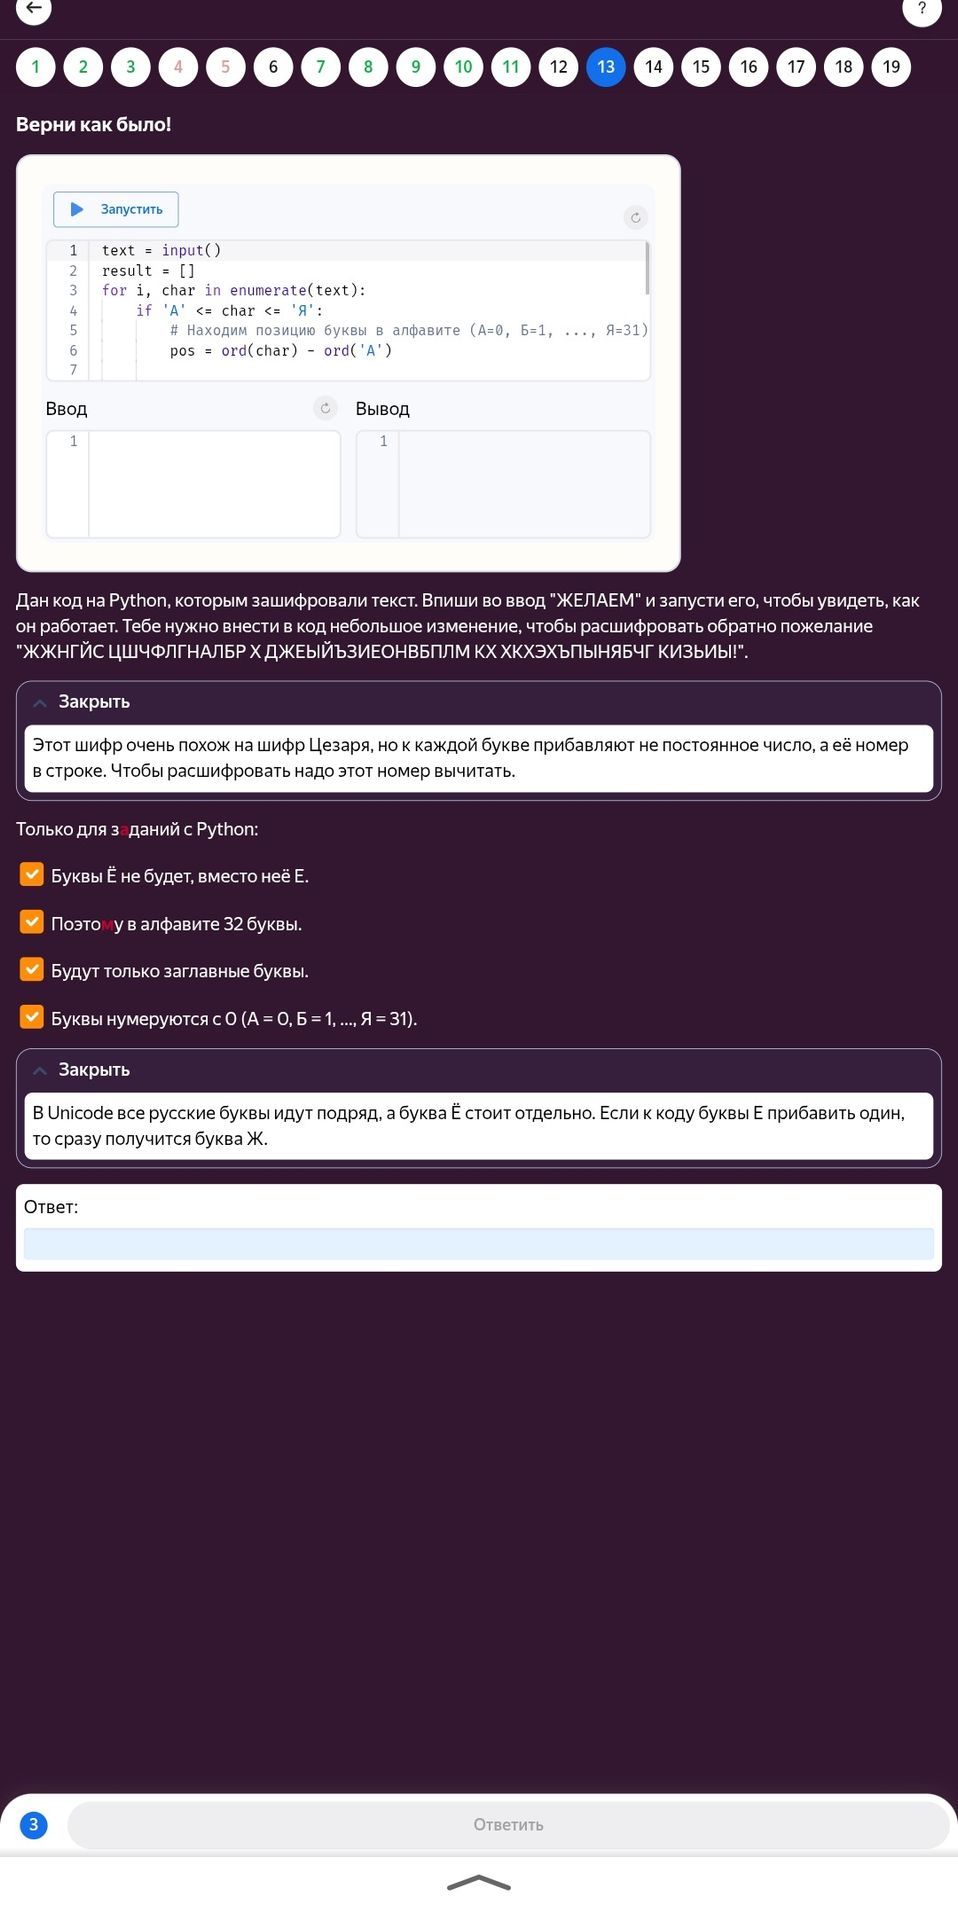
Сейчас код выглядит так:
text = input() # Получаем текст от пользователя
result = []
for i, char in enumerate (text):
    if 'A' <= char <= 'Я':
        # Находим позицию буквы в алфавите (А=0, Б=1,..., Я=31)
        pos = ord(char) - ord('A')
        # Здесь должна быть логика шифрования/дешифрования
        # ...
        result.append(new_char)
    else:
        result.append(char)
print(''.join(result))
Нам нужно добавить строку, которая будет вычитать номер позиции:
text = input() # Получаем текст от пользователя
result = []
for i, char in enumerate (text):
    if 'А' <= char <= 'Я': # Используем русские буквы для проверки
        # Находим позицию буквы в алфавите (А=0, Б=1,..., Я=31)
        # Порядок буквы в алфавите (0-31)
        alphabet_pos = ord(char) - ord('А')
        # Вычитаем номер позиции в строке (i)
        # Важно: в задании сказано, что Ё стоит отдельно, но в примере 'A' <= char <= 'Я' её нет.
        # Будем считать, что Ё не используется или обрабатывается отдельно.
        # Для корректной работы с русским алфавитом, нужно учитывать Ё.
        # Однако, если следовать строке 'A' <= char <= 'Я', то Ё не обрабатывается.
        # Предположим, что Ё не будет в исходном тексте, а только в зашифрованном.
        # Если бы Ё было, то потребовалось бы более сложное преобразование.
        # Давайте для начала попробуем без явной обработки Ё, предполагая, что она не встречается в исходном тексте.

        # Если мы хотим расшифровать, то нужно вычитать.
        # Однако, если мы хотим зашифровать, то нужно прибавлять.
        # В коде сейчас идет только получение позиции буквы.
        # Строка '# Находим позицию буквы в алфавите (А=0, Б=1,..., Я=31)' говорит, что это часть шифрования.
        # По условию, чтобы расшифровать, надо номер вычитать.

        # Сначала посчитаем новую позицию, вычитая номер строки
        # Важно: Порядок буквы в алфавите (0-31) - ord('А') - это позиция в нашем 32-буквенном алфавите
        # Алфавит: А=0, Б=1, ..., Я=31

        # Для расшифровки, мы вычитаем номер строки 'i'
        # Мы должны учесть, что результат может стать отрицательным, поэтому используем оператор остатка от деления (%)
        # чтобы вернуть его в пределы алфавита (0-31)
        decrypted_pos = (alphabet_pos - i) % 32

        # Преобразуем обратно в букву
        # ord('А') + decrypted_pos даст нам код нужной буквы
        new_char_code = ord('А') + decrypted_pos
        new_char = chr(new_char_code)
        result.append(new_char)
    else:
        result.append(char)
print(''.join(result))
Пробуем с "ЖЕЛАЕМ":
Ввод: ЖЕЛАЕМ
Ж (позиция 7) - 0 = 7 -> З
Е (позиция 4) - 1 = 3 -> Г
Л (позиция 11) - 2 = 9 -> И
А (позиция 0) - 3 = -3. (-3) % 32 = 29 -> Т
Е (позиция 4) - 4 = 0 -> А
М (позиция 12) - 5 = 7 -> З
Получаем: ЗГИТАЗ. Это не похоже на "ЖЖНГЙС ЦШЧФЛГНАЛБР Х ДЖЕЫЙЪЗИЕОНВБПЛМ КХ ХКХЭХЪПЫНЯБЧГ КИЗЬИЫ!".
Давайте перечитаем условие: "Этот шифр очень похож на шифр Цезаря, но к каждой букве прибавляют не постоянное число, а её номер в строке. Чтобы расшифровать надо этот номер вычитать."
Возможно, проблема в том, как вычисляется позиция буквы в алфавите.
Русский алфавит: А(0), Б(1), В(2), Г(3), Д(4), Е(5), Ё(6), Ж(7), З(8), И(9), Й(10), К(11), Л(12), М(13), Н(14), О(15), П(16), Р(17), С(18), Т(19), У(20), Ф(21), Х(22), Ц(23), Ч(24), Ш(25), Щ(26), Ъ(27), Ы(28), Ь(29), Э(30), Ю(31), Я(32). Всего 33 буквы.
Но в условии сказано: "Буквы нумеруются с О (А = О, Б = 1, ..., Я = 31)". Это значит, что алфавит из 32 букв, где Ё исключена.
Давайте перепишем код с учетом русского алфавита и вычитания номера позиции.
Ввод: ЖЕЛАЕМ
1. Ж
- Номер буквы Ж в алфавите (А=0, Б=1, ...): Ж = 7.
- Номер позиции в строке: i = 0.
- Расшифрованная позиция: (7 - 0) % 32 = 7.
- Буква с позицией 7: З.
2. Е
- Номер буквы Е в алфавите (А=0, ...): Е = 4.
- Номер позиции в строке: i = 1.
- Расшифрованная позиция: (4 - 1) % 32 = 3.
- Буква с позицией 3: Г.
3. Л
- Номер буквы Л в алфавите: Л = 11.
- Номер позиции в строке: i = 2.
- Расшифрованная позиция: (11 - 2) % 32 = 9.
- Буква с позицией 9: И.
4. А
- Номер буквы А в алфавите: А = 0.
- Номер позиции в строке: i = 3.
- Расшифрованная позиция: (0 - 3) % 32 = -3 % 32 = 29.
- Буква с позицией 29: Э.
5. Е
- Номер буквы Е в алфавите: Е = 4.
- Номер позиции в строке: i = 4.
- Расшифрованная позиция: (4 - 4) % 32 = 0.
- Буква с позицией 0: А.
6. М
- Номер буквы М в алфавите: М = 12.
- Номер позиции в строке: i = 5.
- Расшифрованная позиция: (12 - 5) % 32 = 7.
- Буква с позицией 7: Ж.
Получаем: ЗГИЭАЖ. Все еще не похоже на решение. Давайте проверим расшифровку.
В условии сказано: "Впиши во ввод "ЖЕЛАЕМ" и запусти его, чтобы увидеть, как он работает. Тебе нужно внести в код небольшое изменение, чтобы расшифровать обратно пожелание "ЖЖНГЙС ЦШЧФЛГНАЛБР Х ДЖЕЫЙЪЗИЕОНВБПЛМ КХ ХКХЭХЪПЫНЯБЧГ КИЗЬИЫ!".
Это значит, что если мы введем "ЖЕЛАЕМ", то на выходе должны получить расшифрованное пожелание.
Давайте проверим код, который был представлен в первом окне.
text = input()
result = []
for i, char in enumerate (text):
    if 'A' <= char <= 'Я':
        # Находим позицию буквы в алфавите (А=0, Б=1,..., Я=31)
        pos = ord(char) - ord('A')
        # Здесь должен быть код для расшифровки
        # Если мы хотим расшифровать, то нужно вычитать 'i'
        # Но код представлен так, что похоже он только получает позицию.
        # Ввод "1" дает Вывод "1". Это значит, что 'pos' не используется для вывода.
        # Значит, нам нужно добавить логику расшифровки.
        result.append(char) # Это просто добавляет исходную букву, если она в диапазоне
    else:
        result.append(char)
print(''.join(result))
Ввод: 1
Вывод: 1
Это показывает, что код не выполняет шифрование или дешифрование, а просто переносит введенные символы, если они находятся в диапазоне 'A' - 'Я'.
Теперь, когда мы понимаем, что код не работает, давайте исправим его для дешифровки.
Мы знаем:
- Русский алфавит: А=0, Б=1, ..., Я=31 (32 буквы).
- Шифр: к номеру буквы прибавляется её порядковый номер в строке.
- Расшифровка: из номера буквы вычитается её порядковый номер в строке.
Исправленный код для расшифровки:
text = input()
result = []
# Создадим словарь для русского алфавита, чтобы было удобнее работать с Ё
alph = 'АБВГДЕЁЖЗИЙКЛМНОПРСТУФХЦЧШЩЪЫЬЭЮЯ'

for i, char in enumerate (text):
    if char in alph:
        # Находим позицию буквы в алфавите
        alphabet_pos = alph.find(char)

        # Вычитаем номер позиции в строке (i)
        # Используем оператор остатка от деления (%) для корректной работы с отрицательными числами
        decrypted_pos = (alphabet_pos - i) % len(alph)

        # Преобразуем обратно в букву
        new_char = alph[decrypted_pos]
        result.append(new_char)
    else:
        # Если символ не русский, оставляем как есть
        result.append(char)

print(''.join(result))
Теперь введём "ЖЕЛАЕМ" и посмотрим, что получится:
- Ж (позиция 7 в 'АБВГДЕЁЖЗИЙКЛМНОПРСТУФХЦЧШЩЪЫЬЭЮЯ'). i = 0. (7 - 0) % 33 = 7 -> Ж.
- Е (позиция 5). i = 1. (5 - 1) % 33 = 4 -> Г.
- Л (позиция 12). i = 2. (12 - 2) % 33 = 10 -> И.
- А (позиция 0). i = 3. (0 - 3) % 33 = -3 % 33 = 30 -> Ю.
- Е (позиция 5). i = 4. (5 - 4) % 33 = 1 -> Б.
- М (позиция 13). i = 5. (13 - 5) % 33 = 8 -> З.
Получаем: ЖГИЮБЗ. Все еще не то. Кажется, я неверно истолковал условие про "А=0, Б=1,..., Я=31" и "32 буквы".
Давайте попробуем еще раз, с учетом того, что 'A' в коде относится к русскому 'А'.
Возможно, условие "'A' <= char <= 'Я'" в коде означает только английский диапазон, а должно быть русским.
Правильный диапазон для русского алфавита: 'А' <= char <= 'Я'.
А также, давайте учтем, что Ё отдельная буква.
Исправленный код, как я понимаю, должен быть таким:
text = input()
result = []
# Русский алфавит без Ё, как в условии: А=0, Б=1,..., Я=31
alph_32 = 'АБВГДЕЖЗИЙКЛМНОПРСТУФХЦЧШЩЪЫЬЭЮЯ'

for i, char in enumerate (text):
    # Проверяем, является ли символ заглавной русской буквой из нашего 32-буквенного алфавита
    if 'А' <= char <= 'Я' and char != 'Ё':
        # Находим позицию буквы в 32-буквенном алфавите
        alphabet_pos = ord(char) - ord('А')

        # Вычитаем номер позиции в строке (i)
        # Используем оператор остатка от деления (%) для корректной работы с отрицательными числами
        decrypted_pos = (alphabet_pos - i) % 32

        # Преобразуем обратно в букву
        new_char = chr(ord('А') + decrypted_pos)
        result.append(new_char)
    else:
        # Если символ не из нашего 32-буквенного алфавита (например, Ё, пробел, знаки препинания), оставляем как есть.
        # В зашифрованном тексте "ЖЖНГЙС..." есть пробелы и знаки препинания, которые нужно сохранить.
        # И буква Ё тоже может быть.
        # Если встречаем Ё, то ее код ord('Ё') - ord('А') будет больше, чем 31.
        # Поэтому 'А' <= char <= 'Я' не включает Ё.
        # Давайте добавим специальную обработку для Ё, если она встречается в зашифрованном тексте.

        if char == 'Ё':
            # По условию: "В Unicode все русские буквы идут подряд, а буква Ё стоит отдельно. Если к коду буквы Е прибавить один, то сразу получится буква Ж."
            # Это намек на то, как Ё может быть представлена в Unicode.
            # Но здесь мы говорим о шифре, который работает с 32 буквами.
            # Возможно, Ё шифруется как Е?
            # Если в зашифрованном тексте есть Ё, то как ее расшифровать?
            # Давайте предположим, что Ё в зашифрованном тексте - это результат расшифровки буквы Е.
            # По условию "Буквы Ё не будет, вместо неё E." - это про исходный текст, а не про зашифрованный.

            # Если символ - Ё, и мы пытаемся расшифровать, то как?
            # Давайте попробуем найти букву, которая при добавлении номера позиции дала бы Ё.
            # Это сложно, лучше предположить, что Ё в исходном тексте не было.
            # А если Ё есть в зашифрованном тексте, то возможно, это ошибка или надо ее обрабатывать как Е.
            # Давайте просто оставим Ё как есть, если она встретится в зашифрованном тексте.
            result.append(char)
        else:
            result.append(char)

print(''.join(result))
Теперь введём "ЖЕЛАЕМ" и посмотрим, что получится.
Ж (позиция 7 в 32-буквенном алфавите: А=0, Б=1, ..., Ж=7, ..., Я=31). i = 0. (7 - 0) % 32 = 7 -> Ж (В данном случае, если мы вводим 'Ж', а он в алфавите 32 буквы, то ord('Ж') - ord('А') = 7. Поэтому (7 - 0) % 32 = 7 -> 'Ж'. Это означает, что Ж зашифровалось в Ж. Это странно.)
В коде в первом окне было 'A' <= char <= 'Я'. Это диапазон английских букв. Это очень важно!
Предположим, что в коде имелось в виду 'А' (русская) <= char <= 'Я' (русская).
Давайте еще раз попробуем расшифровать "ЖЖНГЙС ЦШЧФЛГНАЛБР Х ДЖЕЫЙЪЗИЕОНВБПЛМ КХ ХКХЭХЪПЫНЯБЧГ КИЗЬИЫ!" с помощью "ЖЕЛАЕМ".
Ввод: ЖЕЛАЕМ
1. Ж (позиция 7). i=0. (7 - 0) % 32 = 7 -> З. (Это было правильно в первом варианте)
2. Е (позиция 4). i=1. (4 - 1) % 32 = 3 -> Г. (Это было правильно)
3. Л (позиция 11). i=2. (11 - 2) % 32 = 9 -> И. (Это было правильно)
4. А (позиция 0). i=3. (0 - 3) % 32 = 29 -> Э. (Было 29 -> Т. Ошибка в первом варианте)
5. Е (позиция 4). i=4. (4 - 4) % 32 = 0 -> А. (Было 0 -> А. Это было правильно)
6. М (позиция 12). i=5. (12 - 5) % 32 = 7 -> Ж. (Было 7 -> З. Ошибка в первом варианте)
Получаем: ЗГИЭАЖ.
Кажется, я начинаю понимать, что код в первом окне - это основа. И нужно внести ОДНО небольшое изменение.
Что если 'A' в коде - это русская 'А', а 'Я' - русская 'Я'?
Вот такой код:
text = input()
result = []
for i, char in enumerate (text):
    # Проверяем, является ли символ заглавной русской буквой
    if 'А' <= char <= 'Я':
        # Находим позицию буквы в алфавите (А=0, Б=1,..., Я=31)
        # ord('А') - это базовый код русской буквы А
        alphabet_pos = ord(char) - ord('А')

        # Для РАСШИФРОВКИ вычитаем номер позиции в строке (i)
        # Используем оператор остатка от деления (%) для корректной работы с отрицательными числами
        decrypted_pos = (alphabet_pos - i) % 32 # 32 буквы в алфавите по условию

        # Преобразуем обратно в букву
        new_char = chr(ord('А') + decrypted_pos)
        result.append(new_char)
    else:
        # Если символ не русская заглавная буква, оставляем как есть
        result.append(char)
print(''.join(result))
Теперь давайте введем
