
 Алгебра
 Английский
 Биология
 География
 Геометрия
 История
 Русский
 Обществознание
 Физика
 Химия
 Информатика
 Литература
 Математика
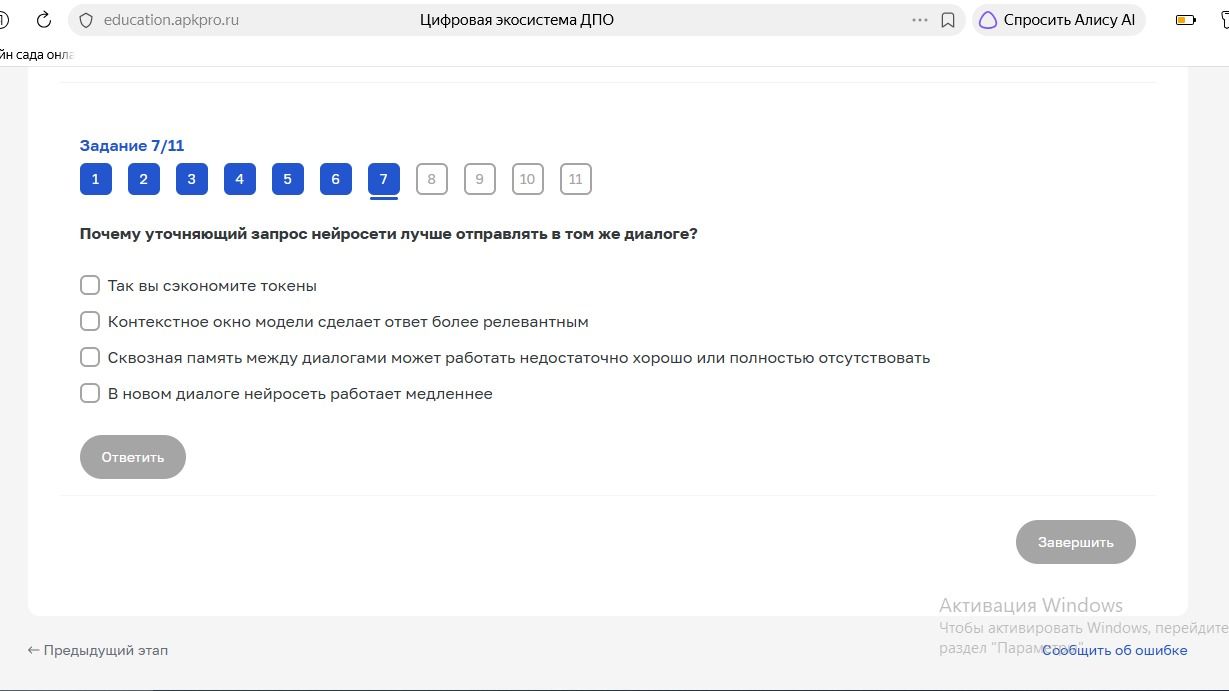
Ответ:
Правильные варианты: 2 и 3.
В том же диалоге модель учитывает предыдущие сообщения и детали запроса, поэтому может дать более релевантный ответ. Между разными диалогами память может быть ограничена или отсутствовать, и тогда контекст придётся объяснять заново. Отправка уточнения в том же диалоге сама по себе не гарантирует экономию токенов; утверждение о том, что в новом диалоге нейросеть работает медленнее, не является верной причиной.
