
 Алгебра
 Английский
 Биология
 География
 Геометрия
 История
 Русский
 Обществознание
 Физика
 Химия
 Информатика
 Литература
 Математика
Ответ:
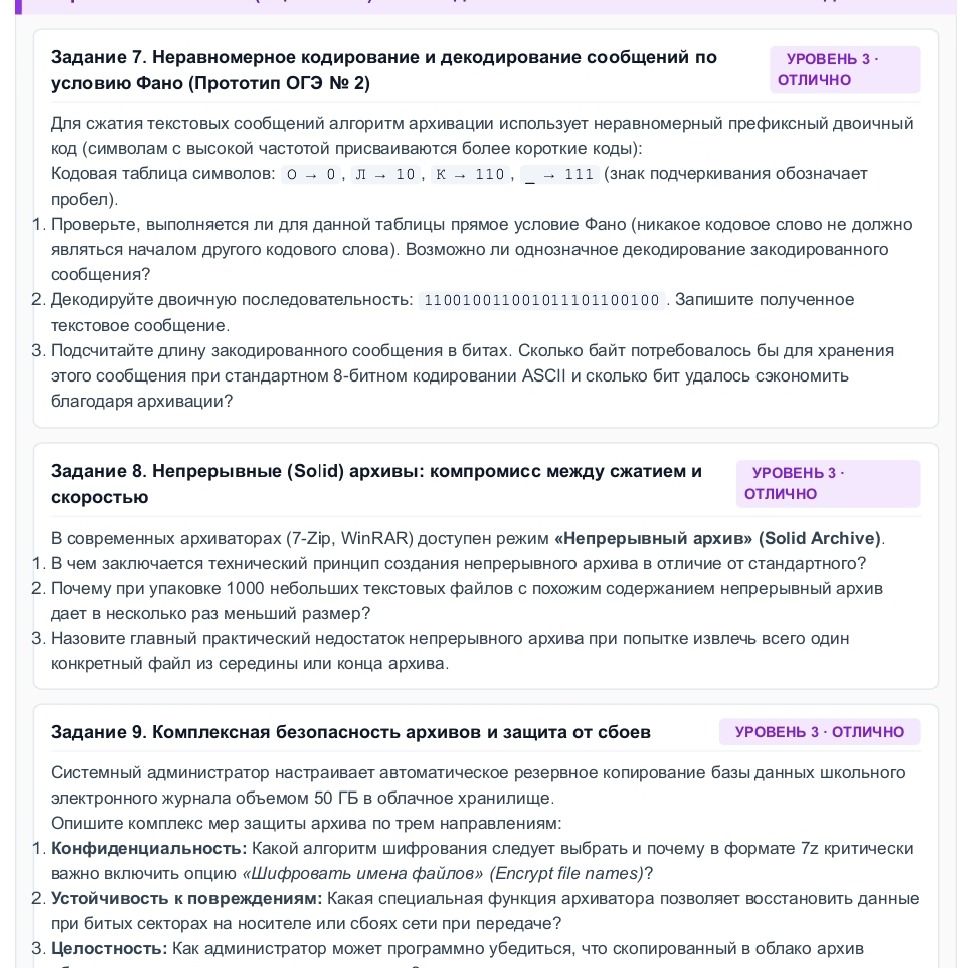
- В обычном архиве файлы сжимаются независимо друг от друга. В непрерывном архиве содержимое нескольких файлов объединяется в один поток сжатия: словарь и найденные повторяющиеся последовательности могут использоваться при обработке последующих файлов.
- Похожие текстовые файлы содержат много одинаковых слов и фрагментов. При непрерывном сжатии повторения между разными файлами также обнаруживаются и кодируются компактно, поэтому общий размер может заметно уменьшиться.
- Чтобы извлечь отдельный файл из середины или конца непрерывного потока, архиватору может понадобиться последовательно распаковать предшествующие данные. Поэтому извлечение одного файла медленнее, а повреждение части потока способно затронуть несколько файлов.
Ответ: непрерывный архив эффективнее сжимает сходные файлы за счёт общего потока и межфайловых повторов, но отдельный файл может быть сложнее и медленнее извлечь.
