
 Алгебра
 Английский
 Биология
 География
 Геометрия
 История
 Русский
 Обществознание
 Физика
 Химия
 Информатика
 Литература
 Математика
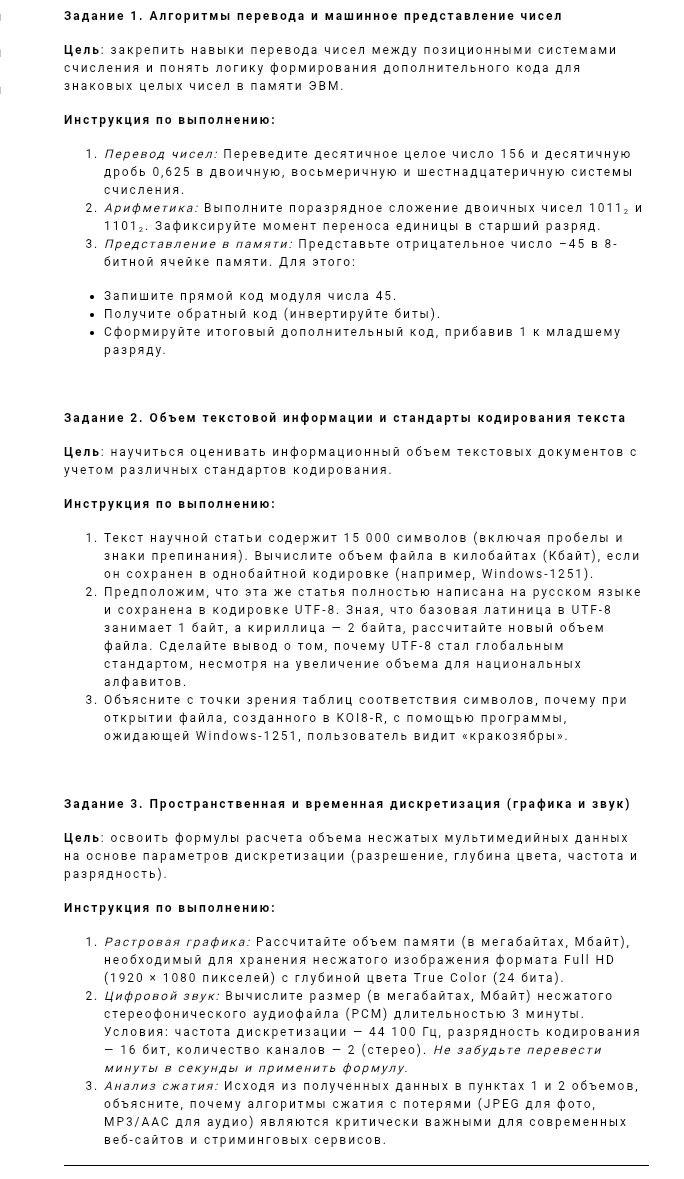
Ответ:
1. Однобайтная кодировка.
Каждый символ занимает 1 байт, значит:
15 000 · 1 = 15 000 байт.
Переводим в килобайты, используя 1 Кбайт = 1024 байта:
15 000 / 1024 ≈ 14,65 Кбайт.
2. Кодировка UTF-8.
Точного количества байтов без числа кириллических и латинских символов определить нельзя: пробелы и знаки препинания, как и символы базовой латиницы, занимают в данном условии 1 байт, а кириллические буквы — 2 байта.
Если обозначить количество кириллических символов через C, размер составит 15 000 + C байт, или (15 000 + C) / 1024 Кбайт. При условном расчёте, если все 15 000 символов — кириллические, получается 30 000 байт / 1024 ≈ 29,30 Кбайт. Реальный объём будет меньше, если в тексте есть пробелы, знаки препинания или латинские символы.
UTF-8 стал глобальным стандартом, потому что позволяет единообразно представлять символы множества языков в одной кодировке и широко поддерживается программами и интернет-протоколами. Он совместим с ASCII для базовой латиницы. Дополнительные байты для многих национальных символов — плата за универсальность и совместимость.
3. Почему возникают «кракозябры».
В каждой кодировке байтам сопоставлены символы по своей таблице. Файл KOI8-R содержит байты, значения которых программа, ожидающая Windows-1251, интерпретирует по другой таблице. Поэтому вместо исходных букв показываются другие символы. Для правильного отображения файл нужно декодировать с использованием KOI8-R.
